Table of Contents
在效率市場假說(Efficient Market Hypothesis, EMH)的理論架構下,股票價格應能充分反映所有可得資訊。然而,實際資本市場中仍普遍存在資訊不對稱現象,不同市場參與者對企業價值之認知與資訊掌握程度亦存在差異。賣方分析師作為資本市場重要的資訊中介者,透過產業研究、企業訪談及財務模型建構,持續提供財務預測、投資評等與目標價等資訊,對市場定價具有一定影響力。然而,單一分析師之觀點仍可能受到承銷業務關係、從眾行為(Herding Effect)或模型假設偏誤等因素影響,進而限制其預測能力與資訊品質。
基於上述考量,本研究以「群眾智慧(Wisdom of Crowds)」概念為出發點,整理「券商共識資料」,將市場中大量且分散的券商研究報告轉化為可量化分析之結構化訊號。理論上,當多數機構法人對特定個股同時形成一致性的樂觀預期時,可能反映市場資金配置方向與未來股價表現之潛在趨勢,因此具備作為量化投資因子的研究價值。
本研究採用量化投資領域廣泛使用之 Alphalens 因子檢定框架,針對 2020 年 1 月至 2025 年 12 月之台灣股票市場進行實證分析,系統性檢驗券商共識資料於不同維度下之 Alpha 預測能力。研究面向涵蓋絕對水準(Level)、變動幅度(Revision)、分歧程度(Dispersion)與市場廣度(Breadth)等四類核心指標,並進一步探討其於實際投資策略建構上的應用價值。
💡 想杜絕回測前視偏誤?探索 TEJ Point-in-Time 投資用財務資料庫,掌握真實回測數據
本研究數據取自市場公開券商報告與歷史行情,聚焦於個股目標價與投資評等資訊。所有數值皆完成除權息與股票分割調整,確保跨期間資料分析之客觀性與一致性。
為確保研究結果具備統計穩定性與實務代表性,本文進一步進行資料篩選與前處理。首先,研究期間設定為 2020 年 1 月至 2025 年 12 月,涵蓋 COVID-19 疫情、全球升息與通膨修正,以及 AI 題材帶動之多頭行情等不同市場環境,可較完整觀察券商共識因子於多空循環中的表現差異。
其次,考量分析師覆蓋數過低可能導致共識資訊失真,本文要求個股至少需具備三家以上券商覆蓋(broker_count ≥ 3),以提高共識指標之代表性與可靠性。經篩選後,研究樣本共涵蓋約 657 檔台灣上市櫃股票,具備相當程度之市場覆蓋率。
表一列示本研究之資料前處理條件與相關設定。
表一、本研究資料前處理及相關設定
| 條件 | 參數 | 說明 |
| 研究期間 | 2020-01-01 ~ 2025-12-31 | 涵蓋 COVID-19、通膨熊市、AI 多頭等完整週期 |
| 最低券商覆蓋數 | broker_count ≥ 3 | 確保共識指標的統計可靠性 |
| 篩選後樣本 | 涵蓋約 657 檔台股標的 |
本研究首先針對單一因子進行量化檢定,並依據單因子之實證結果,進一步建構複合因子以評估不同資訊維度間之交互效果。研究方法採用量化投資領域廣泛使用之 Alphalens 因子分析框架,透過因子值排序將股票分組建構投資組合,並觀察各分組於後續持有期間之報酬表現,以檢驗因子排序與未來報酬之間是否存在穩定的單調性(Monotonicity)關係。
本研究之核心參數設定如下:
為降低不同月份間因子尺度差異對實證結果之影響,所有因子於進入分析前,均先進行月內橫斷面百分位排名,並將因子值標準化至 0 至 1 區間,以提升跨期間資料之可比較性與穩定性。
本研究共建構四項基礎單因子,分別對應券商共識資料中的絕對水準(Level)、變動(Revision)、分歧度(Dispersion)與廣度(Breadth)等不同面向,其定義與計算方式如表二所示。
表二、本研究採用的單構面因子
| 因子 | 原始欄位計算 | 排序方式 |
| rating_rank 「平均投資建議分數」 | 各券商投資建議分數之平均值 | 分數愈高,排序愈高 |
| ir_rank 「平均隱含報酬率」 | (目標價 – 發布日收盤價) / 發布日收盤價 | 報酬愈高,排序愈高 |
| disp1 「券商目標價分歧度」 | 目標價標準差 / 目標價平均數 (目標價已考慮除權息及股票分割事件) | 分歧度愈低,排序愈高 |
| noa2 「淨樂觀券商占比」 | (投資建議評分 ≥ 4 券商數 − ≤ 2 券商數) / 總券商數 | 樂觀度愈高,排序愈高 |
絕對水準(Level)因子主要衡量市場分析師對個股當下之整體看法與評價強度,反映法人機構對公司未來表現之相對樂觀程度。本研究主要檢驗兩項核心單因子:「平均投資建議分數」(rating_rank)與「平均隱含報酬率」(ir_rank)。
「平均投資建議分數」(rating_rank)
rating_rank 係將各券商發布之文字投資評等(包含買進、逢低買進、中立、減碼與賣出)轉換為量化分數後,計算市場平均投資建議分數,並進一步轉換為橫斷面百分位排名,以降低市場整體情緒波動對因子分布之影響。
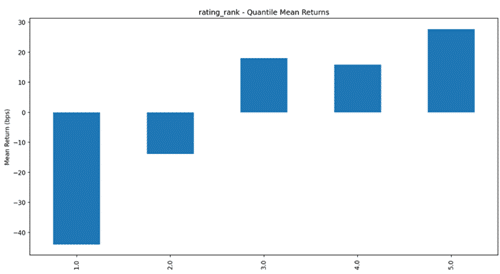
實證結果顯示,rating_rank 之 IC 均值為 0.0191,ICIR 為 0.2109,為本研究表現最佳之單因子之一,顯示該因子對未來報酬具備一定程度之橫斷面預測能力,且相較其他因子具有較佳的穩定性。
從五分位投資組合報酬分布可觀察到,各組別報酬大致呈現隨投資建議分數提高而上升之趨勢。其中,第 5 分位組(平均投資建議分數最高之前 20% 標的)於未來一個月具有相對較佳之平均超額報酬,顯示分析師整體評等仍具有一定的市場定價能力。此外,各分位組間之報酬關係亦呈現近似單調遞增型態,代表市場對分析師評等資訊仍存在部分反應不足(Underreaction)現象。
然而,值得注意的是,賣方分析師普遍存在偏向樂觀之評等傾向,導致高評等標的容易產生集中化現象。尤其在多頭市場環境下,大量個股可能同時獲得「買進」或「優於大盤」評等,使高分群之區辨能力下降。因此,雖然 rating_rank 具備相對穩定之預測效果,但於實務應用上仍需搭配其他因子或額外篩選條件,以降低因高評等擁擠所產生之訊號鈍化問題。
圖一、「平均投資建議分數」分組平均月報酬分析
註1:第 5 組為平均投資建議分數最高之前 20%
註2:各組別的報酬為平減整體平均數後之結果(Alphalens 的設定:Demeaned=True)
「平均隱含報酬率」 (ir_rank)
隱含報酬率的定義為 (目標價 – 發布日之收盤價) / 發布日之收盤價。其經濟意涵在於衡量分析師於發布報告當下,對個股未來潛在上漲空間之預期幅度。本研究將市場平均隱含報酬率進行橫斷面百分位排序後,建構因子 ir_rank,以檢驗分析師目標價相對於現價之偏離程度,是否具備未來報酬之預測能力。
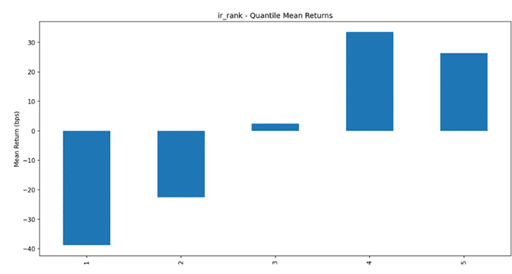
實證結果顯示,ir_rank 之 IC 均值為 0.0154,ICIR 為 0.1346,整體表現低於「平均投資建議分數」(rating_rank),顯示目標價所隱含之上漲空間雖具有一定資訊含量,但其預測穩定性相對較弱。
從五分位報酬分布可觀察到,第 5 分位組(隱含報酬率最高之前 20% 標的)於未來一個月仍具有正向超額報酬,但其績效表現並未明顯優於第 4 分位組,整體分組亦缺乏明確的單調遞增關係。此結果顯示,市場對極端高目標價標的未必完全接受,部分高隱含報酬個股可能同時伴隨較高的不確定性、流動性不足或基本面風險,因而降低因子之穩定性。
此外,該因子之報酬表現具有明顯的波動特性,高報酬往往集中於少數市場快速反彈期間,導致整體績效較易受到特定月份影響。另一項可能原因則與資料有效期間較長有關。本研究所使用之共識資料,係以各月底往前 12 個月內仍屬有效之券商報告進行統計,然而在長達一年之期間內,股價可能已出現大幅波動,使部分較早發布之目標價資訊失去即時性,進而降低平均隱含報酬率之代表性與預測效果。
整體而言,相較於投資建議分數,目標價隱含報酬率雖仍具一定方向性資訊,但其橫斷面解釋能力與穩定性皆相對有限。
圖二、「平均隱含報酬率」分組平均月報酬分析
註1:第 5 組為平均隱含報酬率最高之前 20%
註2:各組別的報酬為平減整體平均數後之結果(Alphalens 的設定:Demeaned=True)
變動水準(Revision)維度主要用以捕捉分析師對個股評價之動態調整行為,亦即追蹤券商於不同時間點對目標價與投資評等之上修或下修幅度。相較於靜態之評價水準,Revision 因子更偏向反映資訊更新速度與市場預期修正程度,因此在理論上可能具備動能或預期修正之效果。
本研究中主要檢驗兩項代表性變動因子:「隱含報酬率變動」(rev_ir_rank)與「投資建議分數變動」(rev_rating_rank),以衡量分析師觀點調整幅度是否具有預測未來報酬之能力。
然而,在實證分析過程中發現一項重要限制:Revision 類因子無法進行有效之分組檢定。其主要原因在於,多數分析師並非每月均會調整其目標價或投資評等,使得變動值在橫斷面分布上呈現高度集中於零值之特性。換言之,大部分個股在絕大多數月份中並未出現評等修正,導致因子分布呈現明顯之離散與稀疏現象,難以形成近似連續分布之排序結構。
在此情況下,傳統以五分位排序(quintile sorting)為基礎之分組方法將難以有效執行,亦無法穩定形成具有經濟意涵之投資組合。此一實證限制顯示,在台灣市場結構下,單純依賴「分析師評等變動」作為獨立動能因子,難以構建穩健且具可操作性的量化選股訊號,未來可能需透過延長觀察期間、事件化定義(event-based definition)或結合其他資訊來源以提升其有效性。
券商分歧度(Dispersion)主要衡量市場上不同券商對同一標的之目標價預期差異程度。本研究以變異係數(Coefficient of Variation)進行定義,即目標價標準差除以目標價平均數,用以標準化不同價格水準下之離散程度。其經濟意涵在於:當分歧度較低時,代表市場對該公司之價值評價較為一致,隱含共識程度較高;反之,當分歧度較高時,則代表分析師對個股未來價值存在較大歧見,可能反映資訊不確定性或市場預期分歧。
「券商目標價分歧度」(disp1)
實證結果顯示,disp1 之 IC 均值為 0.0104,ICIR 為 0.0679,整體表現相對偏弱,顯示單純以目標價分歧程度作為橫斷面預測因子,其資訊含量與穩定性均有限。
從五分位報酬分布可觀察到一個相對反直覺的現象:低分歧組(第 5 分位組)之平均報酬反而呈現顯著負向,而高分歧組(第 1 分位組)則展現相對較佳之正向報酬表現。此結果顯示,在台灣股票市場中,分歧度與報酬之關係並非單純的風險補償結構,而更可能與市場動能特性高度相關。
具體而言,當個股進入強勢多頭或題材發酵階段時,分析師對目標價之調整速度往往存在時間落差,部分券商快速上修目標價,而部分券商仍維持保守立場,進而導致分歧度上升。在此情境下,高分歧度往往伴隨股價趨勢延續,使高分歧組在短期(一個月)內反而取得較佳報酬表現。相對地,低分歧標的通常處於資訊收斂或題材淡化階段,市場關注度較低,因而缺乏進一步的價格推升動能。
整體而言,分歧度在本研究中更接近「資訊更新不一致性」或「動能發展階段指標」,而非傳統意義下之不確定性代理變數。
圖三、「券商目標價分歧度」分組平均月報酬分析
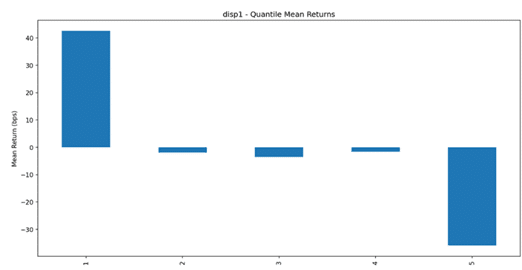
註1:第 5 組為券商目標價分歧度最低之前 20%
註2:各組別的報酬為平減整體平均數後之結果(Alphalens 的設定:Demeaned=True)
廣度指標主要用以衡量市場中分析師樂觀情緒之擴散程度,反映法人圈對個股評價之整體一致性與覆蓋廣度。本研究透過「淨樂觀券商占比」(noa2)建構廣度因子,以捕捉市場共識由分散轉為一致時之資訊變化。
「淨樂觀券商占比」(noa2)
noa2 之計算方式為:
(評等分數 ≥ 4 之券商家數 − 評等分數 ≤ 2 之券商家數)÷ 該標的涵蓋券商總數
透過此一淨額化(netting)設計,可在一定程度上抵銷多空意見並存所造成之雜訊,進而萃取市場整體偏多或偏空之共識強度。
實證結果顯示,noa2 之 IC 均值為 0.0162,ICIR 為 0.1877,整體表現略低於 Level 類因子,但仍具備一定程度之橫斷面預測能力。
從五分位報酬分布可觀察到一項非線性特徵:第 4 分位組(約位於中高樂觀區間)之平均月報酬反而高於第 5 分位組(最高樂觀區間),顯示該因子並未呈現典型單調遞增關係。
此一現象主要反映廣度指標在多頭市場環境下容易出現「鈍化」問題。當市場處於樂觀階段或針對大型權值股時,多數分析師傾向同步給予正向評等,使 noa2 快速接近上限,導致不同標的之間出現高度同質化(ties)現象,進而削弱其橫斷面區辨能力。
因此,noa2 的實證結果顯示,廣度指標在本研究中較適合作為「共識過濾條件」,而非獨立選股因子。其主要功能在於辨識市場是否已進入高度一致的樂觀狀態,並可與具備連續分布特性的 Level 或 Dispersion 類因子結合,以進一步提升選股訊號之細緻度與穩定性。
圖四、「淨樂觀券商占比」分組平均月報酬分析
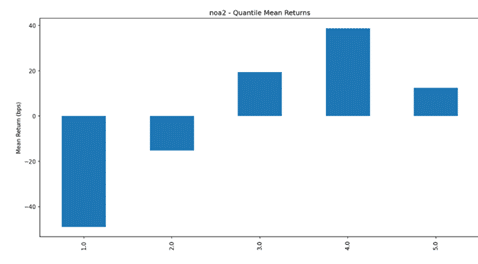
註1:第 5 組為淨樂觀券商占比最高之前 20%
註2:各組別的報酬為平減整體平均數後之結果(Alphalens 的設定:Demeaned=True)
綜合前述單一因子之實證結果可知:投資建議分數較高、券商目標價分歧度較高,以及淨樂觀券商占比較高之標的,整體而言具有較佳之後續報酬表現。然而,單一因子在實務應用上仍可能受到分布偏態、訊號稀疏性或個別雜訊影響,導致其穩定性受限。
為提升因子之穩健性與資訊整合效果,本研究進一步將三大資訊維度——絕對水準(Level)、廣度(Breadth)與分歧度(Dispersion)——進行交叉組合,建構五項複合因子,以期捕捉不同資訊來源間之互補效果,並提升整體 Alpha 訊號之穩定度與可重現性。
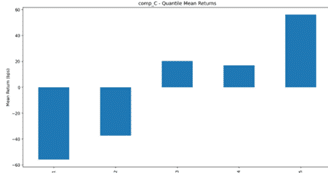
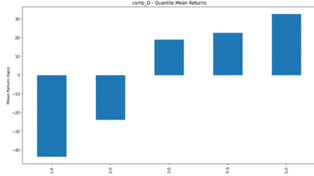
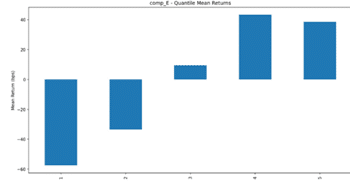
表三整理本研究所建構之五項複合因子,其組成結構及對應之經濟意涵。整體而言,經由因子交互組合後,多數複合因子之分組報酬呈現較為明顯之遞增趨勢,顯示多維度資訊整合有助於提升橫斷面排序之區辨能力,並改善部分單因子在分布或穩定性上的限制。
表三、本研究採用的複合因子
| 複合因子 | 複合因子名稱 | 採用的單因子 | 排序方式(第5分位組) |
| comp_A | 投資建議分數 × 分歧度 | rating_rank、disp1 | 投資建議分數高、分歧度高 |
| comp_B | 隱含報酬率 × 分歧度 | ir_rank、disp1 | 隱含報酬率高、分歧度高 |
| comp_C | 樂觀度 × 分歧度 | noa2、disp1 | 樂觀度高、分歧度高 |
| comp_D | 投資建議分數 × 樂觀度 | rating_rank、noa2 | 投資建議分數高、樂觀度高 |
| comp_E | (投資建議分數+隱含報酬率+樂觀度)3 × 分歧度 | rating_rank、ir_rank、noa2、disp1 | (投資建議分數+隱含報酬率+樂觀度)高、分歧度高 |
註:複合因子排序 = Rank(第一因子排序 與 第二因子排序 乘積)
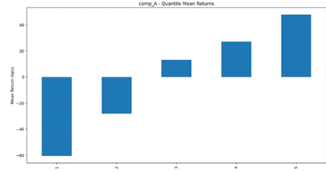
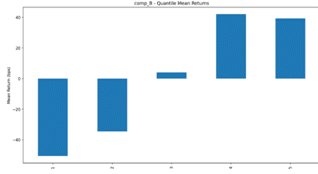
圖五、複合因子之分組平均月報酬分析
在完成單因子與複合因子之實證分析後,本研究進一步以 ICIR(Information Coefficient Information Ratio, 定義為 IC 均值除以 IC 標準差)作為主要排序依據,以評估各因子在橫斷面預測能力上的穩定性,並作為後續策略建構之核心選因標準。相較於 IC 均值僅反映平均預測能力,ICIR 更能衡量因子表現之穩定程度,因此較適合作為實務交易策略之選因依據。
從表四之結果可歸納出數項重要觀察。首先,在單因子維度中,Level 類因子整體表現明顯優於 Dispersion 類因子,其中以「平均投資建議分數」(rating_rank)之 ICIR 表現最佳,顯示分析師整體評等水準相較於分歧程度,更能穩定反映未來報酬方向。其次,在 Breadth 與 Level 之比較中,「淨樂觀券商比重」(noa2)之 ICIR 高於「平均隱含報酬率」(ir_rank),顯示以多券商一致性所構建之廣度資訊,相較於目標價所隱含之報酬空間,更具穩定之預測能力。
在複合因子部分,以 comp_D(投資建議分數 × 樂觀度)表現最為突出,其 ICIR 為全體因子中最高,顯示結合「評等水準」與「市場樂觀廣度」之雙重共識資訊,能有效提升因子穩定性與預測能力。此外,從五分位分組報酬結果可觀察到,comp_D 呈現較為明顯之單調遞增結構,顯示其橫斷面排序能力具備一致性。
值得注意的是,儘管 comp_D 於第 5 分位組所產生之平均超額報酬(約 +33bps)略低於部分以分歧度為核心之複合因子(如 comp_A 與 comp_C,約 +48 至 +55bps),但其主要優勢在於較低之訊號雜訊與較高之穩定性。comp_D 透過「多數券商同步給予正向評等與高度樂觀共識」之嚴格條件,有效排除依賴少數極端目標價所驅動之短期動能標的,使得策略表現更為穩健。
綜合而言,本研究結果顯示,在券商共識資料之應用中,單純追求高報酬幅度之訊號未必具備最佳穩定性,而結合多維度共識資訊所構建之複合因子,尤其是以 comp_D 為代表之「一致性共識因子」,在 ICIR 與報酬單調性之綜合表現上,較適合作為後續實戰策略之核心選因依據。
表四、本研究採用因子之IC均值及ICIR表現
| 維度 | 因子名稱 | 代碼 | IC均值 | IC標準差 | ICIR |
| 複合 | 投資建議分數 × 樂觀度 | comp_D | 0.0200 | 0.0919 | 0.2179 |
| Level | 平均投資建議分數 | rating_rank | 0.0191 | 0.0907 | 0.2109 |
| Breadth | 樂觀券商比重 | noa2 | 0.0162 | 0.0862 | 0.1877 |
| Level | 平均隱含報酬率 | ir_rank | 0.0154 | 0.1141 | 0.1346 |
| 複合 | 樂觀度 × 分歧度 | comp_C | 0.0148 | 0.1462 | 0.1009 |
| 複合 | 投資建議分數 × 分歧度 | comp_A | 0.0128 | 0.1433 | 0.0890 |
| 複合 | (投資建議分數+隱含報酬率+樂觀度)3 × 分歧度 | comp_E | 0.0128 | 0.1502 | 0.0852 |
| Dispersion | 券商分歧度 | disp1 | 0.0104 | 0.1538 | 0.0679 |
| 複合 | 隱含報酬率 × 分歧度 | comp_B | 0.0099 | 0.1484 | 0.0667 |
「【免責聲明】本研究僅供學術探討與量化因子策略檢驗交流之用,內容不涉及任何投資諮詢、買賣推薦。」
🚀 comp_D 實戰表現如何?立即閱讀【下篇:實戰回測】!